前言
上一篇《如何计算自己的Docker需求,从而挑选合适的VPS?》我们根据自己的需求买到了合适的VPS,docker容器流畅的运行起来,一切都很顺利,但是时间一长,随着日志每天长一点,每次构建留一层镜像,数据卷随着业务慢慢变厚,磁盘占用飙到 100%,网站图片集体裂开、数据库报错写不进、连1Panel面板都登不上了。
这不是容器的问题,这是时间一长必然产生的结果。今天我们就来讲一下如何定位磁盘占用,如何在不影响容器运行的情况下,安全地清除磁盘占用,以及配置一套防复发的规则,尽量延长磁盘占用 100% 到来的时间。
用 docker system df 定位磁盘占用
清理之前要先搞清楚吃盘的是谁。通过 SSH 登录VPS机器,执行:
docker system df 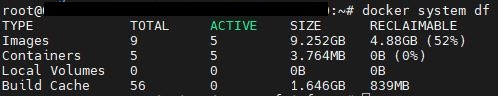
输出四行:Images(镜像)、Containers(容器)、Local Volumes(数据卷)、Build Cache(构建缓存),每行都有 SIZE 和 RECLAIMABLE 两列——后者是"可以回收的部分",比例越高越值得动手。
想知道明细就加 -v,每层镜像、每个卷的占用逐个列出来。再配合这条命令,日志大户一眼现形:
du -sh /var/lib/docker/containers/*/*.log | sort -rh | head 
容器日志清理
三个大头里,容器日志是最常见的元凶。Docker 默认用 json-file 驱动把每个容器的标准输出记录在 /var/lib/docker/containers/ 下的 json 日志文件里,默认配置不轮转——只要容器在跑、日志在写,这个文件就只增不减,数据库和访问量大的业务尤其猛。
临时救急用 truncate 原地清零:
truncate -s 0 /var/lib/docker/containers/容器ID/容器ID-json.log 不要直接 rm:日志文件正被容器进程握着,rm 掉空间不会立刻释放,得重启容器才行;truncate 即时生效,业务无感。
悬空镜像和构建缓存清理
每次 docker build 和 pull 的操作都可能留下没打标签的悬空镜像(docker images 里显示 <none> 的那批),构建过程产生的缓存也在悄悄堆积。可以通过下面几个命令来清理:
docker image prune:只清悬空镜像,安全;docker image prune -a:清所有未被运行中容器引用的镜像,力度大——已经停止的容器占不住镜像,-a 会把它依赖的镜像一起删掉,下次启动重新拉取,小盘机器要权衡;docker builder prune:清构建缓存,经常自己 build 的机器收益明显;docker container prune:能把一堆退出的废弃容器一次清掉。
数据卷清理要格外小心
数据卷里放的是数据库数据、配置文件这类真家伙。清理命令默认是保守的:docker volume prune 只清匿名卷(没命名、随容器生成的临时卷),命名卷一律不动,正常执行是安全的。
但如果加上 --all 把命名卷也纳入清理范围,数据库的卷会连着数据一起没,而且基本没有后悔药。动手前先把重要卷备份一份,一条命令打包到当前目录:
docker run --rm -v 卷名:/data -v $(pwd):/backup alpine tar czf /backup/卷名.tar.gz /data 清之前花一分钟备份,简单又安全。
日志上限、定期清理与CDN分流
清完一次只是还债,不把增长按住,过俩月还得再来一遍。做好一下三件事:
给日志设上限。编辑 /etc/docker/daemon.json:
{ "log-driver": "json-file", "log-opts": { "max-size": "10m", "max-file": "3" }} 意思是单容器日志最多 3 个文件、每个 10MB,转着写。改完执行 systemctl restart docker 让配置生效。
注意 log-opts 只对之后新建的容器生效,已经在跑的存量容器吃不到新配置,得把容器删掉重建一次。用 docker compose 管理的服务分两步:
docker compose down
docker compose up -d
down 负责把这个 compose 文件定义的容器全部停止并删除(数据卷默认保留,数据不丢),up -d 负责按 compose 文件重新创建容器并在后台启动,不加的话服务日志会刷满终端,SSH 一断进程还可能跟着退出。这样重建出来的容器,才带上了日志上限;
定期清理。手动清理还是有点麻烦,我们可以把这个活交给 cron——Linux 系统自带的定时任务工具,到点自动执行指定命令。执行
crontab -e编辑定时任务,加一行:
0 4 * * 1 docker system prune -f 前五个字段是执行时间,依次为分钟、小时、日、月、星期,这行就是"每周一凌晨 4 点准时跑一次清理命令"。docker system prune 会把悬空镜像、已退出的容器、无用网络这些悬空对象一并清掉;-f 是 --force 的缩写,用来跳过"是否继续 (y/N)"的确认,因为cron 是无人值守的,没有人在旁边按 y,不带它的话,定时任务就会卡在确认那一步跑不完。这里刻意不带 -a 和 --volumes,是为了保守清理悬空对象,日常清理已经足够;
把读多写少的资源挪出去。图片、附件、静态文件这类大头放在源站,既占磁盘又吃带宽,分流到 CDN 是治本方案。如果这类静态资源极为庞大,并且还需要频繁访问,可以通过 99CDN 这类自建 CDN 方案把静态资源卸出去,源站的磁盘和带宽一起松绑,具体可以参考VPS DR博客的这篇文章《一文看懂自建CDN到底好不好——99CDN》。
最后,如果日志已经管住、资源也分流了,磁盘还是捉襟见肘,那就真是容量不够了。可以参考我们上一篇文章《如何计算自己的Docker需求,从而挑选合适的VPS?》,重新按"现在的预估数据量×3"换机器,挑新机器时重点核对磁盘参数:容量大小、是不是 NVMe、流量怎么计,像 VMRack 这种自建机房的商家,它的配置页的参数标注得比较细,可以参考看看。
总结
磁盘吃满的处理路径三步:
docker system df 定位磁盘占用;
在容器日志、悬空镜像、数据卷三处清理;
通过限制日志上限+定时清理任务+CDN 分流防复发。
其中日志上限是收益最大的一步,配好之后,大多数 VPS 的磁盘焦虑直接消失一半。